TL;DR: Qwen3.5-35B-A3B en versión uncensored corre a 53 tokens/s en una RTX 5070 Ti de 16 GB con llama.cpp. Con un router local de ~150 líneas aparece en el /model de Claude Code al lado de Opus, en la misma sesión, y Hermes lo usa como un proveedor más. Opus sigue usando tu suscripción y Qwen corre en tu tarjeta, sin cuota y sin filtros. Al final: cómo evitar que pierda el contexto en tareas largas (con la caché medida), cómo actualizar Claude Code sin romperlo y Firecrawl como herramienta extra.
Por qué
Todo empezó con un TikTok: «¿Sin tokens? 6 modelos de IA local para tu PC». La idea es buena: pagas la suscripción, estás en plena entrega y te bloquean tres horas. Pero el video se queda en chatear con modelos sueltos. Yo quería otra cosa:
- Un modelo sin censura para programar pendientes que los modelos comerciales se niegan a tocar.
- Que viva dentro de mis herramientas: Claude Code en la terminal y Hermes como agente.
- Sin perder Opus: cambiar con
/modely regresar, en la misma conversación.
El equipo
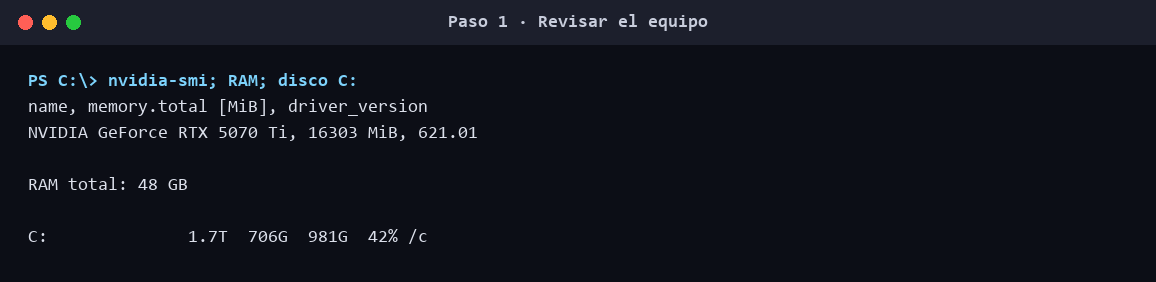
16 GB de VRAM y 48 GB de RAM. El dato importa porque decide el modelo.
Qué modelo y por qué no el del video
| Modelo | Tipo | En 16 GB | Para agentes |
|---|---|---|---|
| Qwen3.8 27B Uncensored (el del video) | Denso | IQ4_XS = 15.3 GB, casi sin espacio para contexto | ❌ |
| Qwen3.5-35B-A3B Uncensored | MoE, ~3B activos | Q4_K_M = 21 GB, parte de los expertos en RAM | ✅ ~50 tok/s |
| Qwen2.5-Coder 1.5B Base | Denso chico | Sobra | Solo autocompletado |
Claude Code y Hermes necesitan 64K tokens de contexto o más: el system prompt y las herramientas ocupan mucho. Un modelo denso de 27B en 16 GB no deja espacio. Un MoE (Mixture of Experts) solo activa ~3B parámetros por token, así que puedes mandar parte de los expertos a la RAM sin que la velocidad se desplome.
Elegí la build de HauhauCS «Aggressive» (0/465 negativas, Apache 2.0), en Q4_K_M.
⚠️ Uncensored significa sin guardrails. La responsabilidad de lo que generes es tuya, y no es algo para exponer a usuarios finales.
Paso 1 · llama.cpp en el disco rápido
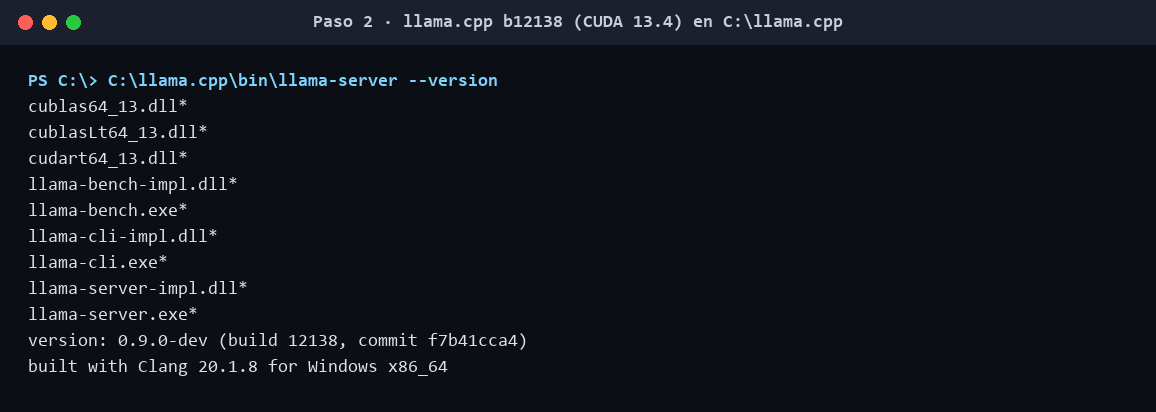
Ollama no tiene control fino para mandar expertos a la RAM; llama.cpp sí (--fit lo hace solo). Bajé el build oficial para CUDA 13.4 (RTX serie 50, Blackwell) y su cudart:
mkdir C:\llama.cpp
# desde https://github.com/ggml-org/llama.cpp/releases
#   llama-bXXXXX-bin-win-cuda-13.4-x64.zip
#   cudart-llama-bin-win-cuda-13.4-x64.zip
# descomprimir ambos en C:\llama.cpp\bin
Paso 2 · El modelo
curl -L -C - -o C:\llama.cpp\models\Qwen3.5-35B-A3B-Uncensored-Q4_K_M.gguf ^
  https://huggingface.co/HauhauCS/Qwen3.5-35B-A3B-Uncensored-HauhauCS-Aggressive/resolve/main/Qwen3.5-35B-A3B-Uncensored-HauhauCS-Aggressive-Q4_K_M.gguf
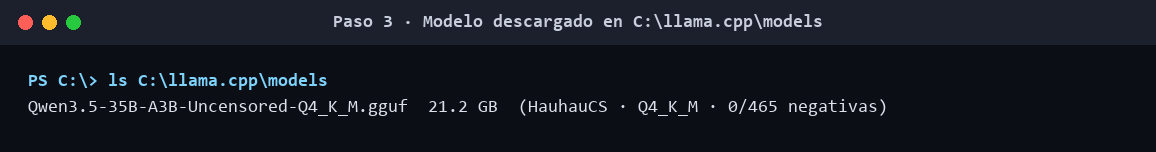
Paso 3 · Levantarlo y medir
llama-server -m C:\llama.cpp\models\Qwen3.5-35B-A3B-Uncensored-Q4_K_M.gguf ^
  --alias qwen-local --host 127.0.0.1 --port 8090 -c 131072 ^
  --jinja -fa on -ctk q8_0 -ctv q8_0 --parallel 1 --load-mode none ^
  --temp 0.6 --top-p 0.95 --top-k 20 --min-p 0
Las banderas que importan:
--jinja: obligatoria para tool calling. Sin ella, el modelo escribe JSON como texto en vez de llamar herramientas.--parallel 1: Qwen3.5 es híbrido (Gated DeltaNet). Con el default de 4 slots va unas 10× más lento.--load-mode none: el propio log lo sugiere cuando hay expertos en CPU. Pasé de 42 a 53 tok/s.-c 131072: el model card pide ≥128K para que razone bien. Quédate debajo de ~155K: arriba de eso la velocidad cae a ~9 tok/s en tarjetas de 16 GB.--port 8090: en mi máquina el 8080 lo ocupa Docker. Además, desde el build b11521 llama-server ya no usa 8080 por defecto: pasa siempre--port.
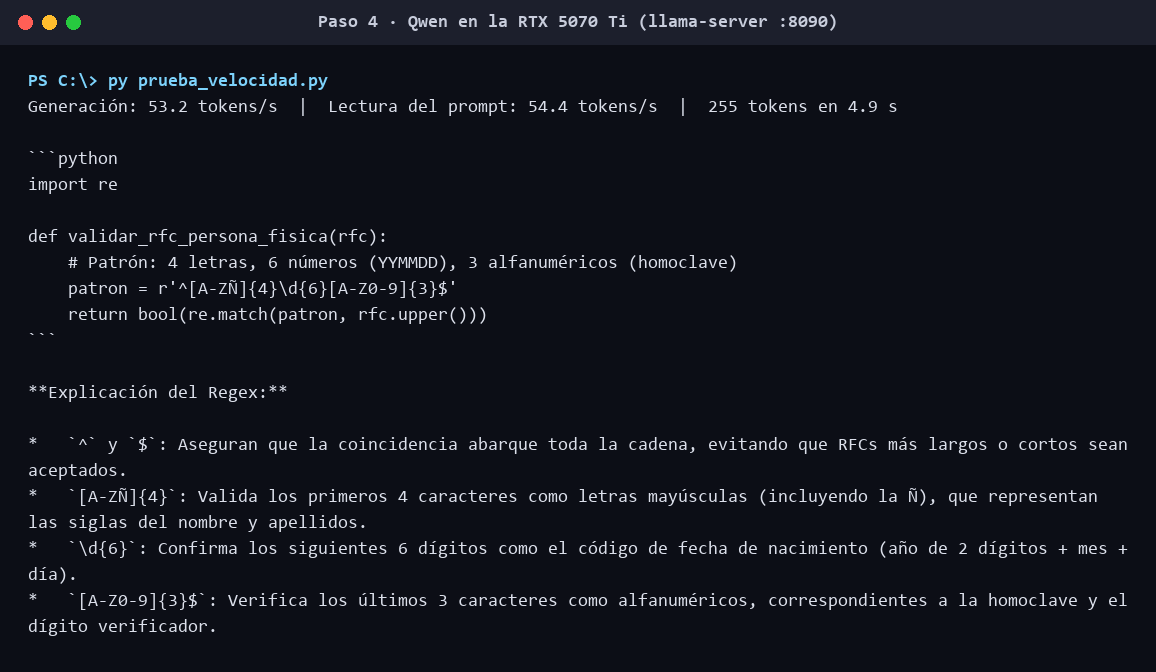
Resultado: 53 tokens/s generando, ~15.6 GB de VRAM y carga en 18 segundos.
Paso 4 · El truco: un router para que conviva con Opus
Claude Code habla con el modelo por ANTHROPIC_BASE_URL, y esa URL es una sola por sesión. Si la apuntas a llama-server, pierdes Opus. La solución es un router local:
model: "qwen*"→ llama-server local. Lo arranca solo la primera vez y lo apaga tras 30 min sin uso, para liberar la VRAM.- Cualquier otro modelo →
https://api.anthropic.com, tal cual, con el login de tu suscripción. /v1/chat/completions(formato OpenAI) → local, para Hermes.
Además limpia las peticiones que van a Qwen. Claude Code manda cosas que un servidor local no entiende: herramientas diferidas (tool search), bloques thinking firmados por Claude, tool_reference, cache_control. Y en sentido inverso, al regresar a Opus quita los bloques de razonamiento que generó Qwen, porque no traen una firma válida.
// router.mjs (fragmento): decidir destino por el campo "model"
const modelo = cuerpo?.model || '';
if (/^qwen/i.test(modelo) && ruta.startsWith('/v1/messages')) {
  await asegurarLlama();                       // lo arranca si está apagado
  return reenviar(req, res, 'local', JSON.stringify(adaptarLocal(cuerpo)));
}
return reenviar(req, res, 'anthropic', JSON.stringify(adaptarAnthropic(cuerpo)));
// adaptarLocal (fragmento): solo herramientas normales, sin las diferidas
b.tools = b.tools.filter((t) => t.input_schema && !t.defer_loading)
  .map(({ name, description, input_schema }) => ({ name, description, input_schema }));
El router escucha en 127.0.0.1:4141 y arranca con Windows desde un .vbs sin ventana en la carpeta Inicio.
Paso 5 · Qwen en el /model de Claude Code
Claude Code (2.1.24x en adelante) trae una opción poco conocida: modelPicker. Agrega filas propias al selector de /model sin quitar las de Anthropic. Como Claude Code no conoce qwen-local, behavesAs le dice que lo trate como Sonnet: perfil de prompt, capacidades y tool search.
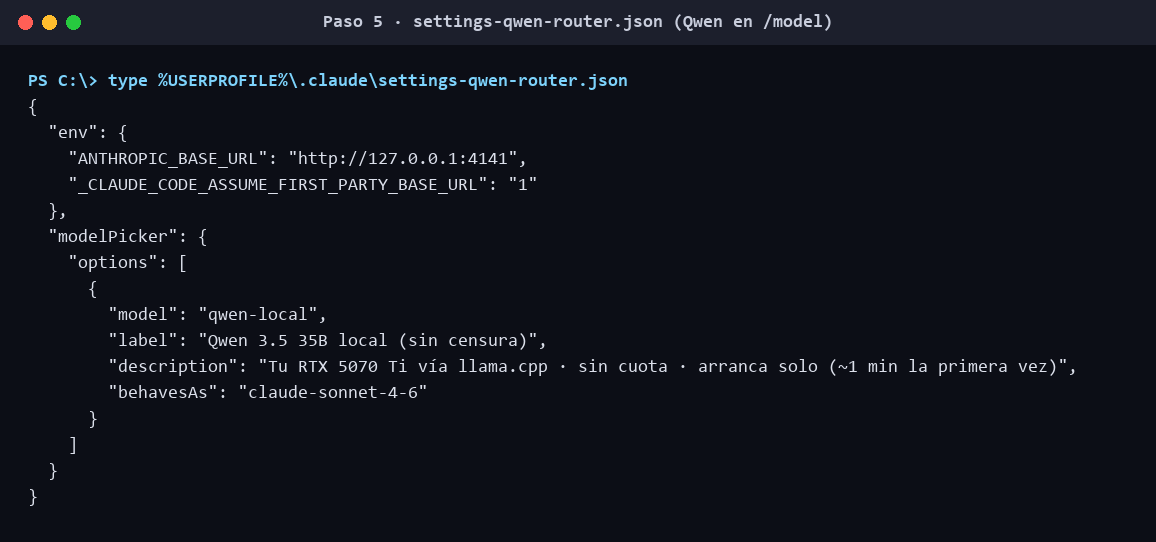
{
  "env": {
    "ANTHROPIC_BASE_URL": "http://127.0.0.1:4141",
    "_CLAUDE_CODE_ASSUME_FIRST_PARTY_BASE_URL": "1"
  },
  "modelPicker": {
    "options": [{
      "model": "qwen-local",
      "label": "Qwen 3.5 35B local (sin censura)",
      "description": "Tu GPU vía llama.cpp · sin cuota",
      "behavesAs": "claude-sonnet-4-6"
    }]
  }
}
Y así se ve en una sesión real: /model muestra a Qwen como la opción 6, debajo de los modelos de Anthropic, con su propia descripción.
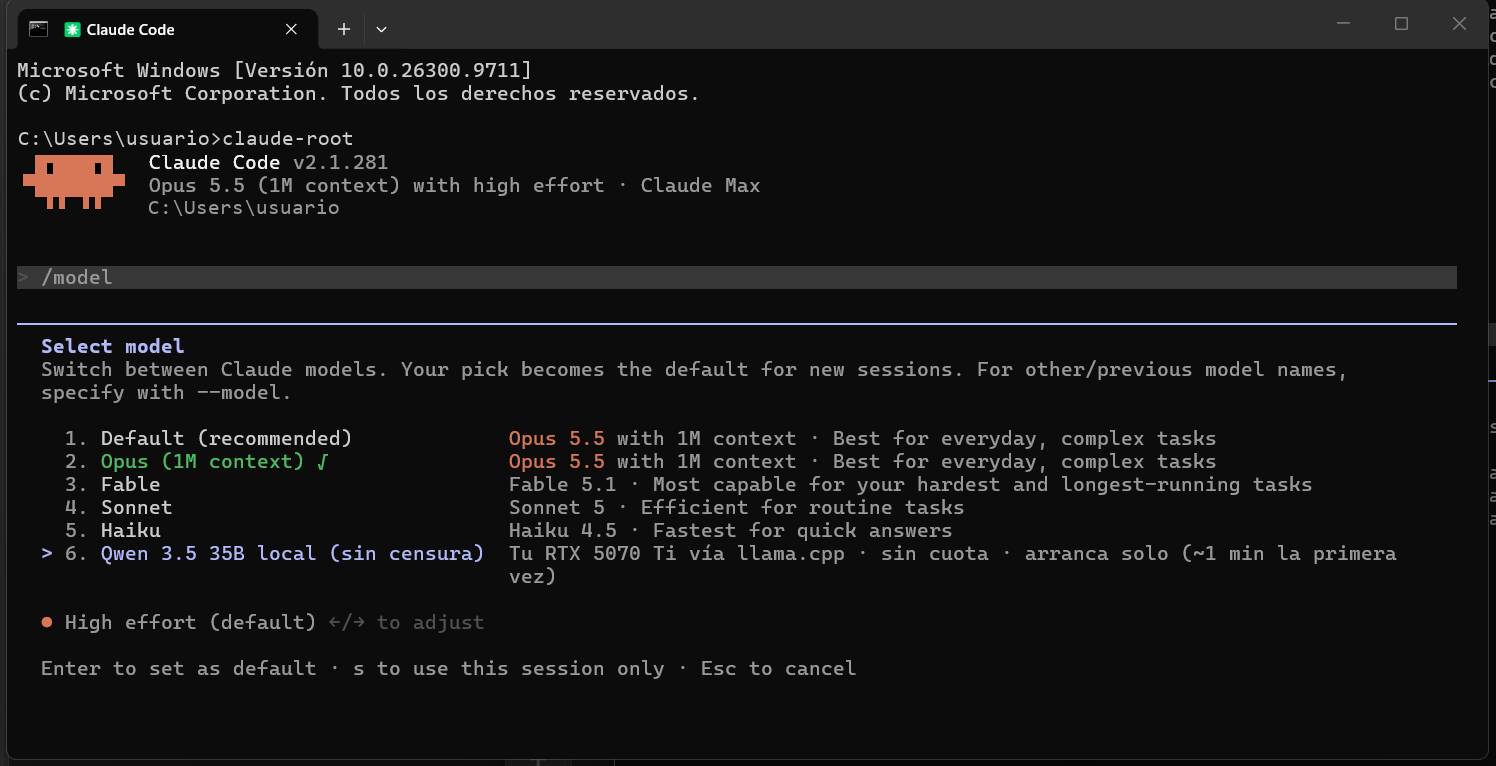
La trampa que casi rompe Opus: cuando ANTHROPIC_BASE_URL no es un host de Anthropic, Claude Code apaga tool search y los betas experimentales. Opus perdería las herramientas diferidas y el contexto de 1M. La variable interna _CLAUDE_CODE_ASSUME_FIRST_PARTY_BASE_URL=1 le dice que el router es transparente. Es interna (lleva guion bajo) y puede cambiar en otra versión, así que hay que vigilarla.
No toqué mi settings.json. Mi lanzador claude-root pasa este archivo con --settings, y si el router no levanta, entra directo como siempre:
@echo off
call "C:\llama.cpp\router\asegurar-router.cmd"
if errorlevel 1 goto directo
claude --dangerously-skip-permissions --settings "%USERPROFILE%\.claude\settings-qwen-router.json" --model claude-opus-5-5[1m] %*
goto :eof
:directo
claude --dangerously-skip-permissions --model claude-opus-5-5[1m] %*
La prueba de fuego: Claude Code con Qwen usando herramientas, y Opus en la misma configuración:
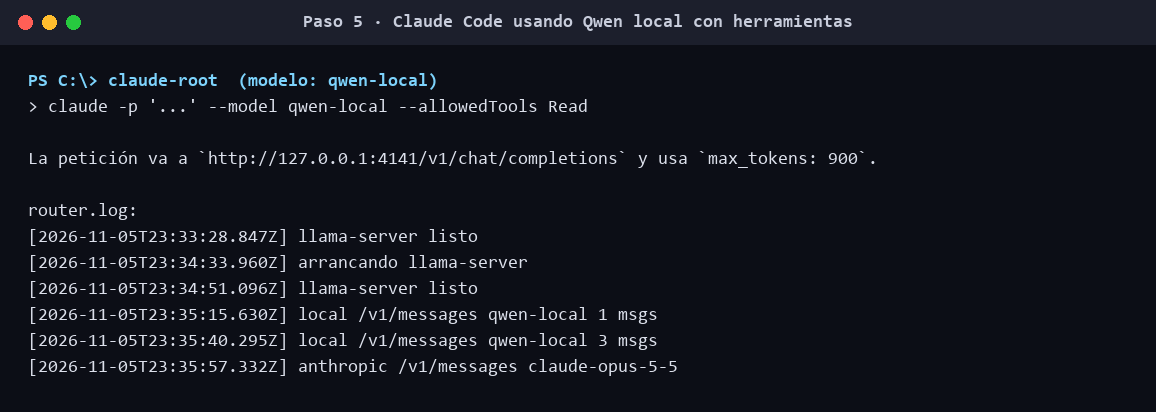
1 msgs → 3 msgs: Qwen pidió la herramienta Read, recibió el archivo y respondió bien. La última línea es Opus por el mismo router, hacia Anthropic.
Paso 6 · Hermes
Hermes Agent habla el formato OpenAI. Basta con un proveedor más en config.yaml, que apunta al router (así también se beneficia del arranque bajo demanda):
providers:
  qwen-local:
    base_url: "http://127.0.0.1:4141/v1"
    model: "qwen-local"
    context_length: 131072   # Hermes exige mínimo 64000
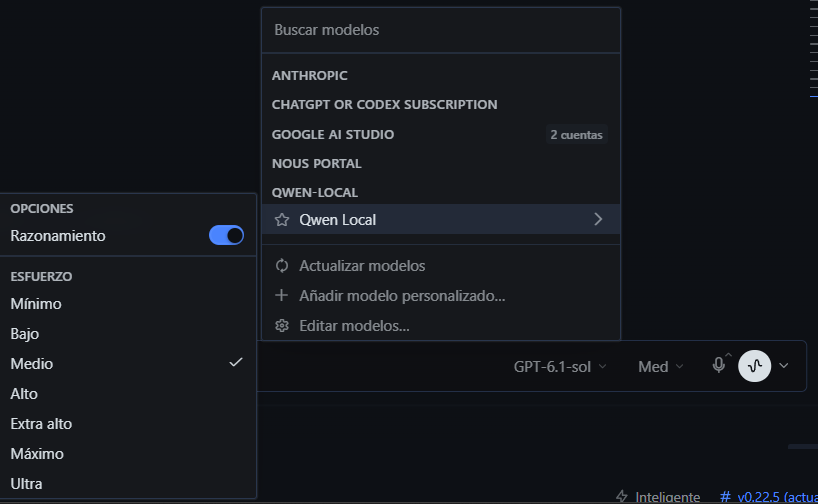
El modelo por defecto de Hermes no cambia; dentro de una sesión se elige con /model → qwen-local. En la app de escritorio aparece como un proveedor más, QWEN-LOCAL, junto a Anthropic, Codex, Google y Nous. Abajo sigue GPT-6.1-sol como modelo por defecto.
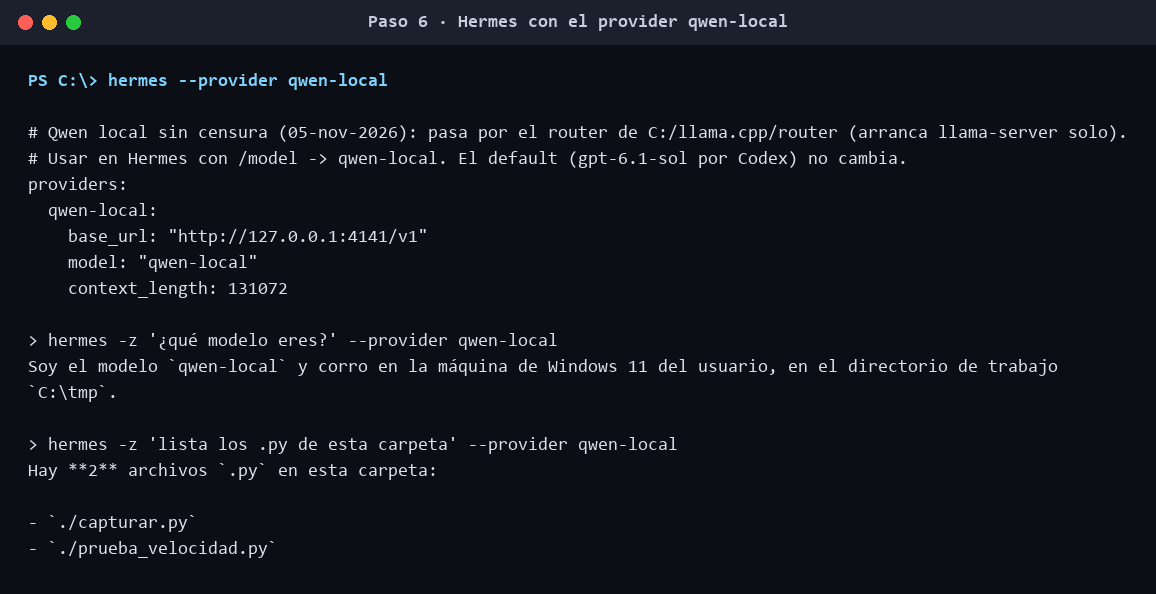
Respondió, y en la segunda prueba usó la herramienta de terminal para contar los .py de la carpeta. Para un agente eso es lo que importa.
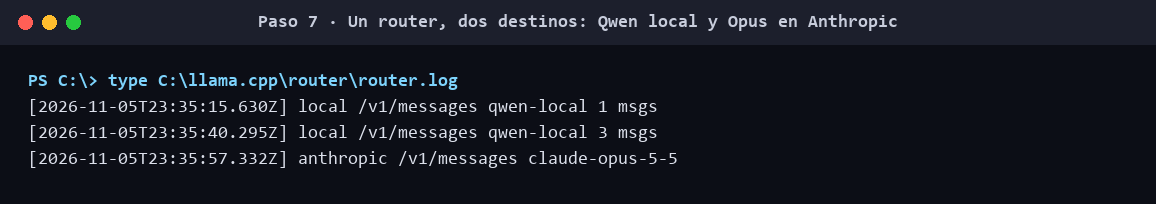
Paso 7 · Un router, dos destinos
Paso 8 · Que no pierda el contexto en tareas largas
Un agente local sirve de poco si a la media hora olvida qué estaba haciendo o tarda un minuto en releer todo en cada turno. Investigué Reddit (r/LocalLLaMA), los issues de llama.cpp y la documentación de Hermes, y medí en mi máquina.
La caché entre turnos: medida, no supuesta
llama-server guarda en memoria el prompt anterior (caché KV) y en el siguiente turno solo procesa lo nuevo. Le agregué al router un registro de cuántos tokens salen de esa caché:
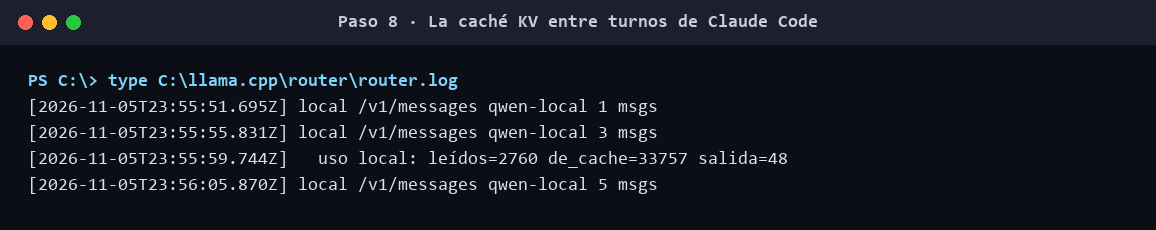
En el segundo turno, 33,757 tokens salieron de caché y solo 2,760 se procesaron nuevos (~92 %). Dato que sorprende: el prompt base de Claude Code, con mis herramientas, CLAUDE.md y memoria, ya pesa ~36K tokens antes de escribir nada.
La trampa nº 1: el encabezado que cambia en cada petición
El problema más reportado con Claude Code + Qwen3.5 local es que reprocesa TODO el prompt en cada turno (llama.cpp #20003). El culpable: Claude Code mete al inicio del system prompt una línea x-anthropic-billing-header: ... cc_prompt_id=... que cambia en cada petición. Un solo token distinto al principio invalida toda la caché.
Dos defensas:
// settings.json → env
"CLAUDE_CODE_ATTRIBUTION_HEADER": "0"
// router.mjs: por si acaso, se normaliza antes de mandarlo a llama-server
const FACTURACION = /x-anthropic-billing-header:[^\n]*/g;
b.system = b.system.replace(FACTURACION, 'x-anthropic-billing-header: fijo');
La regla de oro que repite la comunidad: nunca mutar el historial. Qwen3.5 es híbrido (Gated DeltaNet) y, si cambia algo atrás, llama.cpp tiene que reprocesar completo. Mi router siempre hace las mismas limpiezas, por eso la caché sí pega.
¿Más contexto? Lo medí
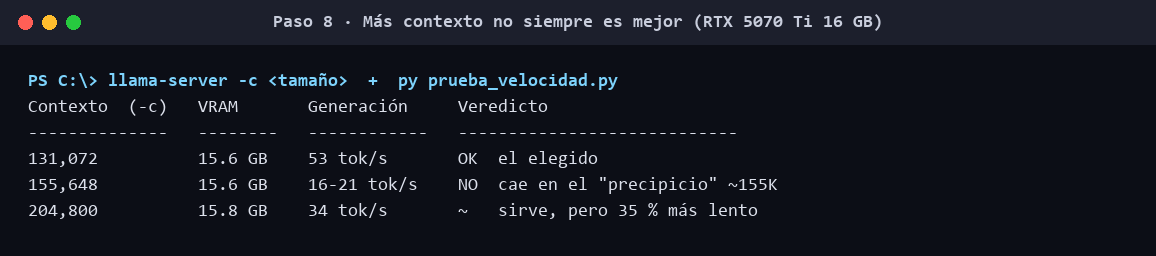
Con 16 GB, subir la ventana obliga a mandar más expertos a la RAM. A ~155K aparece el “precipicio” que reportan en Reddit (aquí, 16–21 tok/s). Me quedé en 131K. Claude Code cree que Qwen tiene 200K (por behavesAs) y, con mi CLAUDE_AUTOCOMPACT_PCT_OVERRIDE=60, compacta a los ~120K: debajo de los 131K reales.
Hermes: el resumen se prepara antes de necesitarlo
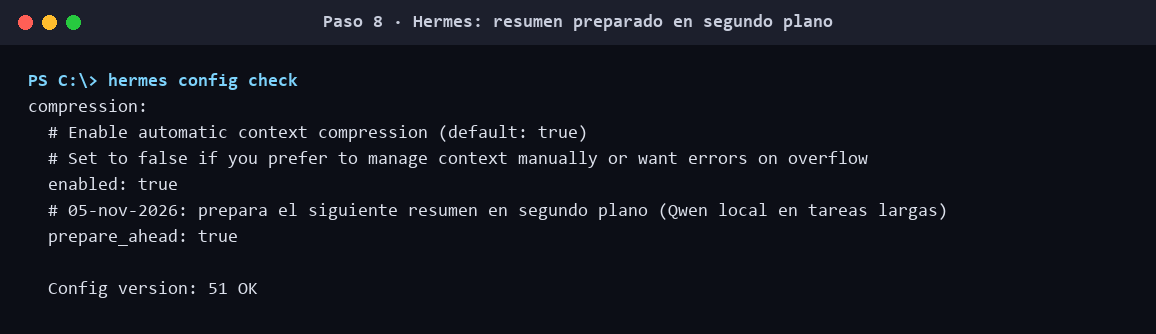
Hermes ya trae buena compactación: el modo lean conserva textuales rutas, SHAs, errores y los mensajes del usuario, y con ventanas menores a 512K compacta al 75 %. Le activé prepare_ahead: cuando se acerca al límite, escribe el resumen en segundo plano, y al compactar solo lo pega.
compression:
  enabled: true
  prepare_ahead: true
Cómo trabajo tareas largas
- El estado vive en disco, no en el chat. Al arrancar le pido: “lleva un
PLAN.mdy unPROGRESO.mdy actualízalos tras cada paso”. Si compacta, los relee y sigue. - Una tarea por sesión y luego
/clear. Las sesiones eternas son las que más pierden. /compactcon foco:/compact conserva rutas, decisiones y el siguiente paso.- Compactar antes = compactar más rápido. Toda compactación invalida la caché; con menos contexto, el resumen sale antes.
Actualizar Claude Code sin romper nada
El plugin live-compact, que compacta en segundo plano, necesita Claude Code 2.1.287+. Antes de actualizar de 2.1.281 a 2.1.318 revisé las 37 versiones del changelog buscando lo que tocara este montaje:
- A favor: desde la 2.1.287 los mods vienen activos; la 2.1.299 subió de 180 a 300 s la espera de respuestas por un
ANTHROPIC_BASE_URLpropio (justo lo que necesita un modelo local leyendo prompts largos); la 2.1.317 corrigió conversaciones largas que perdían su resumen. - Neutral: el sufijo
[1m]se sigue aceptando; releer un archivo sin cambios ahora devuelve el contenido completo. - Riesgo:
_CLAUDE_CODE_ASSUME_FIRST_PARTY_BASE_URLes interna y no aparece en el changelog.
Por eso actualizo con un script que prueba Opus y Qwen por el router y regresa solo a la versión anterior si algo falla:
$anterior = (claude --version) -replace ' .*',''
try {
    npm install -g @anthropic-ai/claude-code@latest
    $opus = claude -p "Di tu modelo" --settings $s --model 'claude-opus-5-5[1m]'
    $qwen = claude -p "hola" --settings $s --model qwen-local
    if ($opus -notmatch 'Opus' -or -not $qwen) { throw "falló una prueba" }
    $ok = $true
} finally {
    if (-not $ok) { npm install -g "@anthropic-ai/claude-code@$anterior" }
}
Ojo en Windows: hay que cerrar todas las sesiones de Claude antes, o npm no puede reemplazar el ejecutable.
Bonus · Firecrawl para investigar
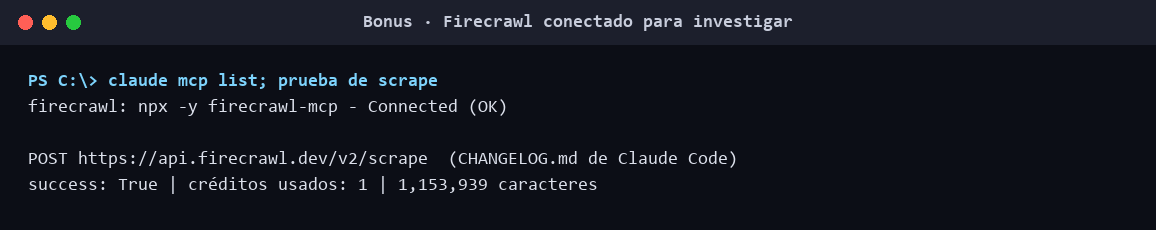
Para esta investigación usé Exa y también conecté Firecrawl (plan gratis, 1,000 créditos al mes) como MCP en Claude Code y como clave en Hermes. La clave vive en un solo .env central y de ahí se copia. Con él traje el changelog completo de Claude Code (1.1 millones de caracteres) gastando 1 crédito.
claude mcp add firecrawl --scope user -e FIRECRAWL_API_KEY=<TU_CLAVE> -- npx -y firecrawl-mcp
Errores que me encontré (para que no te pasen)
- Acentos rotos con curl en Git Bash:
ill-formed UTF-8 byte. Manda el JSON desde Python o desde un archivo. timeouten un.cmdejecutado desde Git Bash llama altimeoutde GNU, no al de Windows. Usaping -n 2 127.0.0.1 >nul.printfy heredocs se comen\ren rutas comoC:\llama.cpp\router(\r= retorno de carro) y me rompieron el YAML de Hermes. Escribe esos archivos con un editor o con Python en raw.- Puerto 8080 ocupado por Docker. Revisa con
netstat -ano | findstr :8080antes de elegir puerto. - Abliterado ≠ gratis: quitar las negativas puede empeorar el tool calling. Pruébalo con una tarea real antes de confiarle trabajo. Esta build pasó leer archivos y usar la terminal.
Cómo deshacerlo
- Restaurar los lanzadores originales (los respaldé antes de tocarlos).
- Quitar el bloque
providers: qwen-localy la líneaprepare_ahead: truede Hermes. - Borrar el
.vbsde la carpeta Inicio ytaskkill /IM llama-server.exe /F.
Mi settings.json de Claude Code nunca se tocó.