Quería saber si mi tarjeta de video podía hacer videos para redes con voz incluida, sin pagar créditos de Veo ni de Higgsfield. La respuesta corta es que sí. Con una RTX 5070 Ti de 16 GB saco un clip de 5 segundos en 720p, con una persona diciendo una frase en español, en menos de 2 minutos. Costo por clip: cero.
Lo hice con MiniMax H3, el modelo de video que MiniMax liberó como open weights en agosto de 2026, y con FastH3, su versión destilada de 8 pasos. Este es el registro real: qué instalé, cuánto tarda, qué falla y cuándo conviene cada modo.
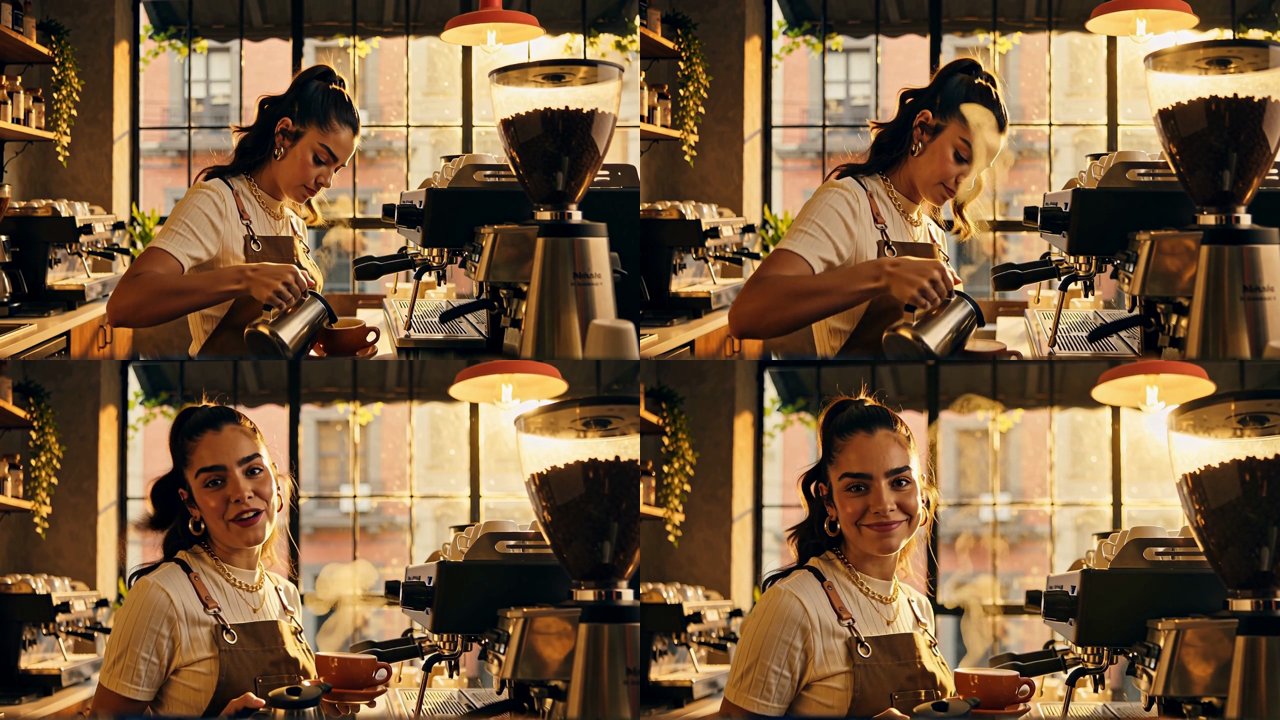
Este clip salió de mi PC, imagen y sonido. El prompt pedía que la barista dijera “El mejor café de la colonia”, y lo dice:
FastH3 · 1280×720 · 5 s · 8 pasos · 114 s en una RTX 5070 Ti.
TL;DR
- MiniMax H3 genera video + audio estéreo (voz, efectos y música) en una sola pasada, a 24 fps y hasta 15 s. Los pesos abiertos producen ~768p nativo; el 2K del servicio en línea se logra reescalando.
- Corre en 16 GB de VRAM, pero necesita ComfyUI 0.30 o más nuevo (yo usé la 0.43) y mucha RAM.
- Mis tiempos con FastH3: 480p en 60 s y 720p en 114 s por clip de 5 s. Con el modelo base + turbo LoRA: 76 s y 229 s.
- El cuello de botella es la RAM, no la GPU. Con 47 GB llegué a 42 GB en el pico de 720p.
- Licencia: uso comercial gratis fuera de EE. UU., la UE, Reino Unido y Corea, por debajo de 20 M USD al año. En México sí aplica.
1. Por qué H3 y no otro modelo
En 16 GB ya hay varias opciones de video local. Así las veo después de investigar y probar:
| Modelo | Audio | Para qué lo uso | Licencia |
|---|---|---|---|
| MiniMax H3 / FastH3 | ✅ estéreo | Clips con diálogo, ambiente o música; sigue muy bien el prompt | Community (comercial OK fuera de EE. UU., UE, UK y Corea) |
| Wan 2.2 A14B | ❌ | Video mudo con fotogramas exactos (inicio y fin), el ecosistema de LoRAs más grande | Apache 2.0 |
| LTX-2.x | ✅ | El más rápido; buena alternativa con audio | Gratis por debajo de 10 M USD |
Ya tenía Wan 2.2 funcionando para tomas mudas. Lo que me faltaba era la voz: con Wan tenía que generar el audio aparte y empatarlo a mano. H3 lo hace junto con la imagen.
2. Instalación: una copia nueva de ComfyUI, sin tocar la vieja
Mi ComfyUI de siempre era la 0.22, con más de 120 custom nodes y Wan 2.2 funcionando. H3 necesita 0.30 o más. En vez de arriesgar la que ya servía, instalé una portable nueva aparte.
- Bajé
ComfyUI_windows_portable_nvidia.7z(v0.43, ~2 GB) de los releases de GitHub y lo descomprimí enC:\ComfyUI-H3\. Trae Python 3.13 y PyTorch 2.14 + CUDA 13, que es lo que piden los kernels optimizados de H3. - Dejé los modelos en una carpeta propia,
C:\ComfyUI-H3\models\, y se la indiqué a ComfyUI conComfyUI\extra_model_paths.yaml:
h3:
  base_path: C:/ComfyUI-H3/models
  diffusion_models: diffusion_models
  text_encoders: text_encoders
  vae: vae
  loras: loras
- La levanto en otro puerto (8189) para que no choque con la vieja (8188), y siempre con
--disable-pinned-memory:
cd C:/ComfyUI-H3/ComfyUI_windows_portable
PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True \
python_embeded/python.exe -s ComfyUI/main.py --windows-standalone-build \
  --listen 127.0.0.1 --port 8189 --disable-auto-launch --disable-pinned-memory
No corras las dos instalaciones a la vez. Cada una carga decenas de GB en RAM y no caben juntas.
Los modelos exactos (~61 GB)
Todos vienen de Hugging Face (Comfy-Org/MiniMax-H3, y FastH3 de FastVideo/FastVideo-FastH3-Comfy):
| Archivo | Tamaño | Carpeta |
|---|---|---|
fastvideo_fasth3_8step_v2_pruned_int8_convrot.safetensors |
22.1 GB | diffusion_models/ |
minimax_h3_fl2va_pruned_int8_convrot.safetensors (base, para I2V) |
21.0 GB | diffusion_models/ |
qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors (codificador de texto) |
15.7 GB | text_encoders/ |
minimax_h3_video_vae_int8_convrot.safetensors |
2.8 GB | vae/ |
minimax_h3_audio_vae_fp32.safetensors |
0.6 GB | vae/ |
minimax_h3_fl2v_turbo_8step_v1.0_comfyui_bf16.safetensors |
2.0 GB | loras/ |
Los bajé con curl -L -C -, así que si se corta, se reanuda. Con un NVMe y buena conexión son unos 20 minutos.
¿Por qué estas versiones? Las pruned int8 son las que usan las plantillas oficiales: el modelo completo en bf16 pesa 62 GB y no tiene sentido en 16 GB de VRAM. El codificador nvfp4 ocupa la mitad que el int8 y en una GPU Blackwell (serie RTX 50) corre nativo.
3. Generar sin abrir la interfaz: la API
No quería arrastrar nodos cada vez, así que repliqué la plantilla oficial (video_fastvideo_fasth3_t2v) como grafo de API y la mando desde un script en Python. El corazón del modo FastH3 es esta cadena:
UNETLoader (FastH3) → MiniMaxH3SigmaShift (video 10 / audio 3)
  → ModelAttentionBackend ("comfy kitchen attention")
  → BlockSparseAttention (vsa, keep_percent 10)        ← la atención dispersa que lo acelera
  → BasicScheduler (simple, 8 pasos) + BasicGuider
CLIPLoader (qwen3vl nvfp4, type "minimax") → MiniMaxH3ImageToVideo (prompt, ancho, alto, cuadros)
SamplerCustomAdvanced (res_multistep) → VAEDecode (video) + VAEDecodeAudio (audio) → CreateVideo (24 fps) → SaveVideo
Y el script queda así:
python_embeded/python.exe comfy_h3.py --prompt prompt.txt --ancho 1280 --alto 720 --segundos 5 --fasth3
El script encola el trabajo, espera a que termine y mide el tiempo, la VRAM pico y la RAM pico con psutil y nvidia-smi. Cada corrida se agrega a un mediciones.jsonl.
Detalle de la API que no está documentado a la vista: los nodos nuevos usan combos dinámicos. La subopción se manda con punto:
"format": "auto", "format.codec": "auto"enSaveVideo, y"selection": "vsa", "selection.keep_percent": 10enBlockSparseAttention.
El prompt
El prompt va en inglés. La frase que debe decir el personaje va entre comillas y en el idioma en que la quieres oír:
Vertical-friendly product ad, realistic cinematic look: a young Mexican barista in a cozy
Mexico City coffee shop at golden hour pours latte art into a ceramic cup, steam rising,
then looks at the camera, smiles and says in Spanish: "El mejor café de la colonia."
Shallow depth of field, warm light, handheld camera slowly pushing in. Natural sound of the
espresso machine, soft acoustic guitar music in the background.
Para comprobar que la voz no era un murmullo, pasé el audio por Whisper. En los dos modos devolvió exactamente: “El mejor café de la colonia”.
4. Mediciones reales (RTX 5070 Ti 16 GB · 47 GB de RAM)
Todas las pruebas son de 5 segundos (124 cuadros) a 8 pasos, con Chrome y VS Code abiertos, o sea, mi PC tal como la uso a diario:
| Modo | 864×480 | 1280×720 | VRAM pico | RAM pico |
|---|---|---|---|---|
| FastH3 (VSA + comfy kitchen attention) | 60 s | 114 s (11 s/paso) | 15.3 GB | 42 GB |
| Base + turbo LoRA de 8 pasos | 76 s | 229 s (26 s/paso) | 15.3 GB | 42 GB |
| FastH3 vertical 480×864, 3 s | 40 s | — | — | — |
FastH3 es el doble de rápido en 720p. La atención dispersa VSA solo calcula el 10 % de los bloques de video que más importan. Para comprobar que estaba activa, encendí el modo verbose del nodo y busqué sparse producer path en el log.
Como referencia, una RTX 5080 con 64 GB de RAM reportó 720p en ~76 s con FastH3. La diferencia sale de que la 5080 tiene ~20 % más núcleos y más RAM libre.
Aquí está la comparación del mismo prompt en los dos modos:
FastH3 (más contraste y saturación):
Base + turbo LoRA (más natural, el doble de lento):
Y en vertical para Reels o TikTok (480×864, 3 s, 40 s de generación):
5. Cuándo usar cada modo
| Necesidad | Modo |
|---|---|
| Texto → video con voz, música o efectos (anuncio, B-roll con ambiente) | FastH3 |
| Partir de una foto (primer y último fotograma) | Base + turbo LoRA. FastH3 no hace I2V ni referencias |
| Look más natural, menos saturado | Base + turbo LoRA, o base a 20 pasos (más lento) |
| Personaje o voz de referencia (Ref2V) | Checkpoint ref2va aparte (~20 GB más) y la plantilla video_minimax_h3_r2v |
| Video mudo que tiene que terminar exacto en una imagen | Wan 2.2 (FLF2V), no H3 |
Sobre la duración: H3 trabaja en una rejilla de 17k+5 cuadros a 24 fps, así que 5 s se convierten en 124 cuadros. Lo entrenaron para clips de 5 a 15 s. Para algo más largo, se encadenan clips partiendo del último cuadro del anterior.
6. Trampas que pisé (o que pisaron otros antes)
- La RAM es el límite real. El modelo (20 GB) y el codificador de texto (15 GB) no caben en 16 GB de VRAM, así que ComfyUI los va pasando por la RAM. En el pico de 720p me quedaron 4.5 GB libres de 47. Con clips de 10 a 15 s o con Ref2V va a paginar a disco.
--disable-pinned-memoryes obligatorio en Windows. Sin esa bandera, ComfyUI intenta reservar memoria fija y el proceso se cae.- I2V en 1280×720 da error en 16 GB, según reportes de otros usuarios. Usa alto de 704 (o 704×1280 en vertical).
- FastH3 sale más saturado y en un clip me dejó una mancha de vapor junto a la cara durante uno o dos cuadros. Revisa siempre los cuadros antes de publicar. Una tira se saca con ffmpeg:
ffmpeg -i clip.mp4 -vf "select='not(mod(n\,8))',scale=200:-2,tile=8x1" -frames:v 1 tira.png - El 2K no viene en los pesos abiertos. El escalador a 2K de MiniMax es solo del servicio en línea. En local se genera a ~768p y se reescala aparte.
- Que los primeros pasos digan
dense ... outside the start/end windowes normal: la atención dispersa entra a partir del 20 % del muestreo.
7. ¿Más RAM o una segunda GPU?
Antes de esta prueba pensaba comprar otra tarjeta igual para “tener 32 GB”. Después de medir, la primera compra es RAM:
- Dos GPUs no suman VRAM: cada modelo sigue cargándose en una sola tarjeta de 16 GB.
- El nodo nativo MultiGPU CFG Split de ComfyUI acelera hasta ~1.9×, pero solo cuando CFG > 1. Los modos rápidos (FastH3, turbo) usan CFG = 1, así que no ganan nada.
- Una segunda GPU sí sirve para generar dos clips en paralelo (ComfyUI-Distributed) o para mover el codificador de texto a la otra tarjeta.
- Con 2×48 GB de RAM (96 GB) desaparece el riesgo de paginar con clips largos, por una fracción del precio de una GPU.
¿Y los equipos tipo DGX Spark / ASUS Ascent GX10 con 128 GB de memoria unificada? Les cabe todo, pero en video son entre 2.4 y 5.5 veces más lentos que una RTX 5090: en una prueba publicada, el mismo clip tardó 237 s contra 51 s. Para producir contenido, una GPU de escritorio con mucha RAM sigue ganando.
8. La licencia, en claro
H3 usa la MiniMax H3 Community License:
- Territorio permitido: todo el mundo excepto EE. UU., la Unión Europea, Reino Unido y Corea del Sur. En esos países hace falta licencia de pago.
- Uso comercial gratis por debajo de 20 M USD de ingresos al año.
- La regla del territorio aplica también a dónde se usan los videos. Yo no lo uso en piezas para clientes o audiencias de EE. UU.; para eso uso Wan o LTX.
- Si haces una app o un servicio que genere con H3, tienes que mostrar “MiniMax H3” en la interfaz. En contenido, marcarlo como generado con IA es buena práctica.
- No puedes usar los videos para entrenar otros modelos.
Cierre
Ahora tengo un canal de video con voz en español, gratis y privado en mi propia PC. Lo integré a mi flujo de generación como una etiqueta: le pido a mi agente "@h3 hazme un clip de…" y él levanta el servidor, genera, mide y lo apaga.
Lo siguiente es hacer lo mismo con imágenes (Z-Image Turbo en la misma GPU) y armar un sistema de atajos para generar contenido por red social. Eso irá en los próximos posts.